前面分析了JDK1.7中HashMap的源码,它是通过是“数组+链表”实现的,但在JDK1.8中对HashMap的实现做了很大的变动和优化,改为了用“数组+链表或红黑树”来实现。
下面先讲一下红黑树相关内容。
红黑树
二叉查找树
介绍红黑树之前我们要先理解二叉查找树的数据结构,下面简单介绍一下。
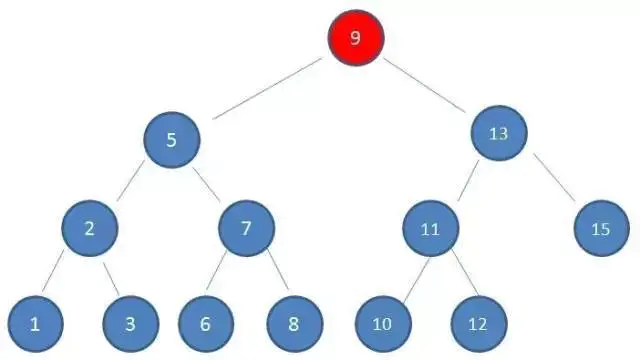
上面这张图就是一个二叉查找树。二叉查找树有如下几条特性:
- 左子树上所有结点的值均小于或等于它的根结点的值。
- 右子树上所有结点的值均大于或等于它的根结点的值。
- 左、右子树也分别为二叉排序树。
既然名字中有“查找”,那么到底是怎么查找的呢?
比如我们要查找10这个元素,查找过程为:首先找到根节点,然后根据二叉查找树的第一二条特性,我们知道要查找的10>9所以是在根节点的右边去查找,找到13,10<13,所以接着在13的左边找,找到11,10<11,继续在11的左边查找,这样就找到了10。这其实就是二分查找的思想。我们要查出结果所需的最大次数就是二叉树的高度!
总结一下二分查找的思想:找到数组的中间位置的元素v,将数组分成>v和<\v两部分,然后将v和要查找的数据进行一个比较,如果大于v那么就在>v的部分再次进行二分查找,否则就在<\v的部分进行二分查找,直到找到对应的元素。
那既然要查出结果所需的最大次数就是二叉树的高度,那这个高度会不会有时候很长呢?
比如我们依次插入 根节点为9如下五个节点:7,6,5,4,3。依照二叉查找树的特性,结果会变成什么样呢?7,6,5,4,3一个比一个小,那么就会成一条直线,也就是成为了线性的查询,时间复杂度变成了O(n)级别。为了解决这种情况,该红黑树出场了。
红黑树
**红黑树其实就是一种自平衡的二叉查找树。**它这个自平衡的特性就可以对HashMap中链表可能会很长的问题做出优化。
**红黑树是每个节点都带有颜色属性的二叉查找树,颜色或红色或黑色。**除了二叉查找数的特性,红黑树还有如下单独的特性:
- 每个节点是红色或黑色。
- 根节点是黑色。
- 每个叶节点(NIL节点,空节点)是黑色的。
- 每个红色节点的两个子节点都是黑色。(从每个叶子到根的所有路径上不能有两个连续的红色节点)
- 从任一节点到其每个叶子的所有路径都包含相同数目的黑色节点。
如下就是一个典型的红黑树:
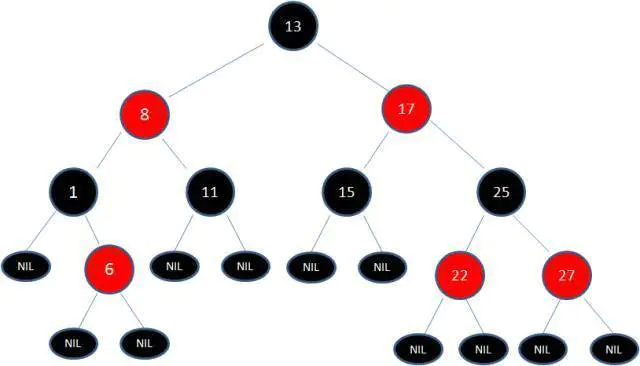
红黑树那么多规则,那么在插入和删除元素会不会破坏红黑树的规则呢?什么情况下会破坏?什么情况下不会?
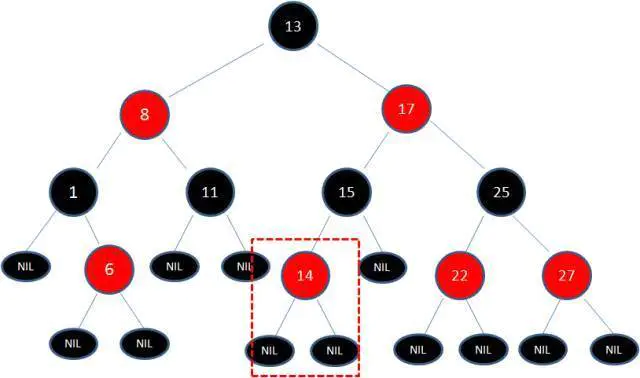
比如我们向原红黑树插入为14的新节点就不会破坏规则:
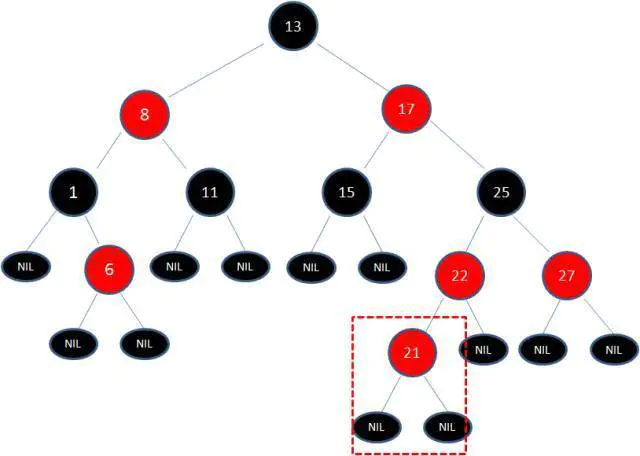
向原红黑树插入值为21的新节点就破坏了规则:
那么红黑树是怎么维护这个二叉查找树的自平衡性的呢?
红黑树通过“变色”和“旋转”来维护红黑树的规则,变色就是让黑的变成红的,红的变成黑的,旋转又分为“左旋转”和“右旋转”。这个比较复杂,这里就不展开讲,只需要知道红黑树就是通过这种方式来实现它的自平衡性就行了。
源码分析
下面分析一下JDK1.8中的HashMap源码。
几个重要属性
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
|
static final int DEFAULT_INITIAL_CAPACITY = 1 << 4;
static final int MAXIMUM_CAPACITY = 1 << 30;
static final float DEFAULT_LOAD_FACTOR = 0.75f;
static final int TREEIFY_THRESHOLD = 8;
static final int UNTREEIFY_THRESHOLD = 6;
static final int MIN_TREEIFY_CAPACITY = 64;
transient Node<k,v>[] table;
transient Set<map.entry<k,v>> entrySet;
transient int size;
transient int modCount;
int threshold;
final float loadFactor;
|
数据结构
在JDK1.8中HashMap是“数组+链表或红黑数”的结构,当一个桶中的节点数比较少时,这些节点以一个单向链表存储在桶中,当节点数大于8则转为红黑树。
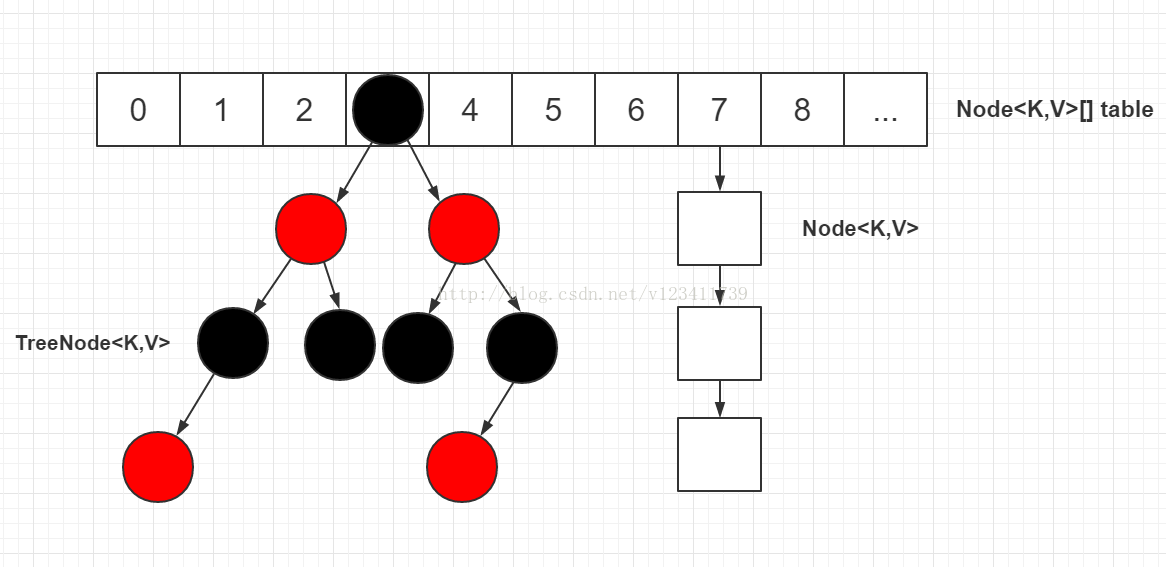
如果是链表,节点上的元素是一个Node<K,V>实例;如果是红黑树,节点上的元素是一个TreeNode<K,V>实例。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
|
static class Node<K,V> implements Map.Entry<K,V> {
final int hash;
final K key;
V value;
Node<K,V> next;
}
static final class TreeNode<K,V> extends LinkedHashMap.Entry<K,V> {
TreeNode<K,V> parent;
TreeNode<K,V> left;
TreeNode<K,V> right;
TreeNode<K,V> prev;
boolean red;
}
|
构造器
和JDK1.7中的HashMap类似,有4个构造器。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
| public HashMap() {
this.loadFactor = DEFAULT_LOAD_FACTOR;
}
public HashMap(int initialCapacity) {
this(initialCapacity, DEFAULT_LOAD_FACTOR);
}
public HashMap(int initialCapacity, float loadFactor) {
if (initialCapacity < 0)
throw new IllegalArgumentException("Illegal initial capacity: " +
initialCapacity);
if (initialCapacity > MAXIMUM_CAPACITY)
initialCapacity = MAXIMUM_CAPACITY;
if (loadFactor <= 0 || Float.isNaN(loadFactor))
throw new IllegalArgumentException("Illegal load factor: " +
loadFactor);
this.loadFactor = loadFactor;
this.threshold = tableSizeFor(initialCapacity);
}
public HashMap(Map<? extends K, ? extends V> m) {
this.loadFactor = DEFAULT_LOAD_FACTOR;
putMapEntries(m, false);
}
final void putMapEntries(Map<? extends K, ? extends V> m, boolean evict) {
int s = m.size();
if (s > 0) {
if (table == null) {
float ft = ((float)s / loadFactor) + 1.0F;
int t = ((ft < (float)MAXIMUM_CAPACITY) ?
(int)ft : MAXIMUM_CAPACITY);
if (t > threshold)
threshold = tableSizeFor(t);
} else if (s > threshold)
resize();
for (Map.Entry<? extends K, ? extends V> e : m.entrySet()) {
K key = e.getKey();
V value = e.getValue();
putVal(hash(key), key, value, false, evict);
}
}
}
|
从上面可以看出,除了入参为指定Map的构造器,其它情况下在创建HashMap实例时,都不会创建去创建一个哈希数组,即执行构造器后table仍然为null,直到第一次执行put方法时table才会通过resize()方法创建一个数组。
put方法
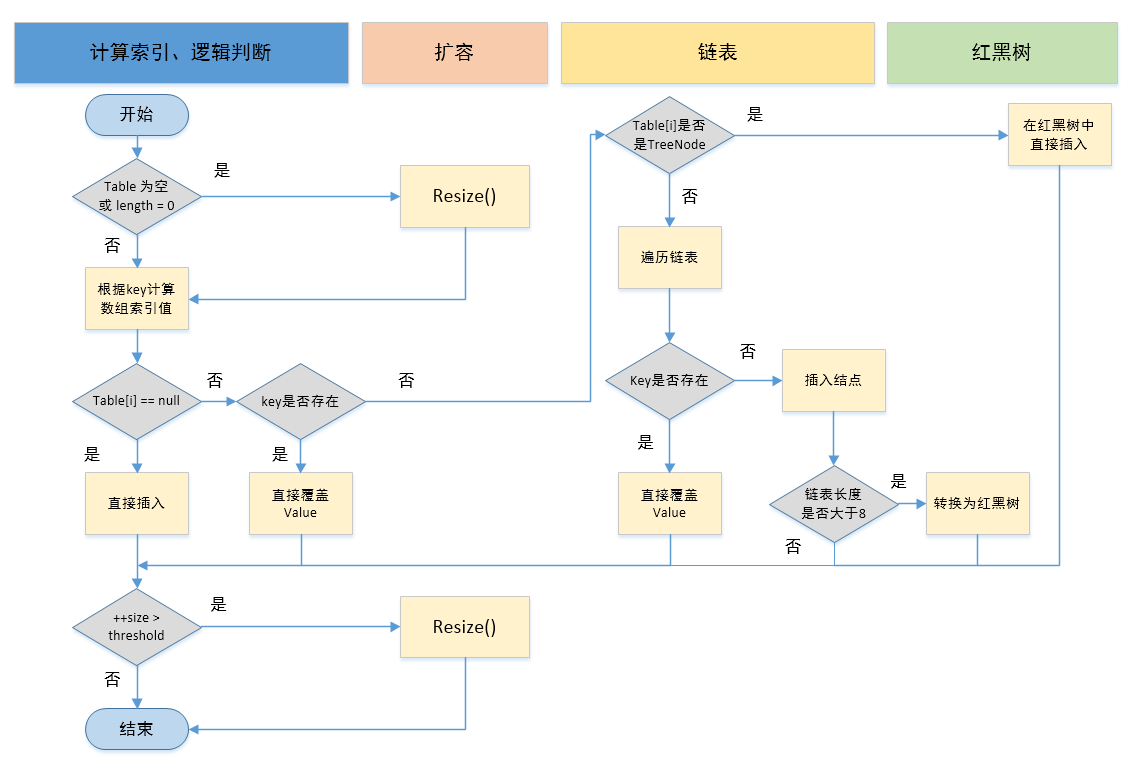
put流程的主要步骤:
①.判断键值对数组table[i]是否为空,为空则执行resize()进行扩容;
②.根据key计算hash值得到插入的数组索引i,如果table[i]==null,直接新建Node添加到i位置,转向⑥,如果table[i]不为空,转向③;
③.判断table[i]的首个元素是否和要添加的key一样,如果相同直接覆盖value,否则转向④,这里的相同是指key的hashCode和equals相同;
④.判断table[i] 是否为treeNode,即table[i] 是否是红黑树,如果是红黑树,则直接在树中插入键值对,否则转向⑤;
⑤.遍历table[i],判断链表长度是否大于8,大于8的话把链表转换为红黑树,在红黑树中执行插入操作,否则进行链表的插入操作;遍历过程中若发现key已经存在直接覆盖value即可;
⑥.插入成功后,判断实际存在的键值对数量size是否超多了最大容量threshold,如果超过,进行扩容。
流程图如下:
具体详细源码分析如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
|
public V put(K key, V value) {
return putVal(hash(key), key, value, false, true);
}
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
boolean evict) {
Node<K,V>[] tab; Node<K,V> p; int n, i;
if ((tab = table) == null || (n = tab.length) == 0)
n = (tab = resize()).length;
if ((p = tab[i = (n - 1) & hash]) == null)
tab[i] = newNode(hash, key, value, null);
else {
Node<K,V> e; K k;
if (p.hash == hash &&
((k = p.key) == key || (key != null && key.equals(k))))
e = p;
else if (p instanceof TreeNode)
e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
else {
for (int binCount = 0; ; ++binCount) {
if ((e = p.next) == null) {
p.next = newNode(hash, key, value, null);
if (binCount >= TREEIFY_THRESHOLD - 1)
treeifyBin(tab, hash);
break;
}
if (e.hash == hash &&
((k = e.key) == key || (key != null && key.equals(k))))
break;
p = e;
}
}
if (e != null) {
V oldValue = e.value;
if (!onlyIfAbsent || oldValue == null)
e.value = value;
afterNodeAccess(e);
return oldValue;
}
}
++modCount;
if (++size > threshold)
resize();
afterNodeInsertion(evict);
return null;
}
|
resize方法
在put方法中会调用resize()方法,resize()也属于HashMap中一个重要方法。
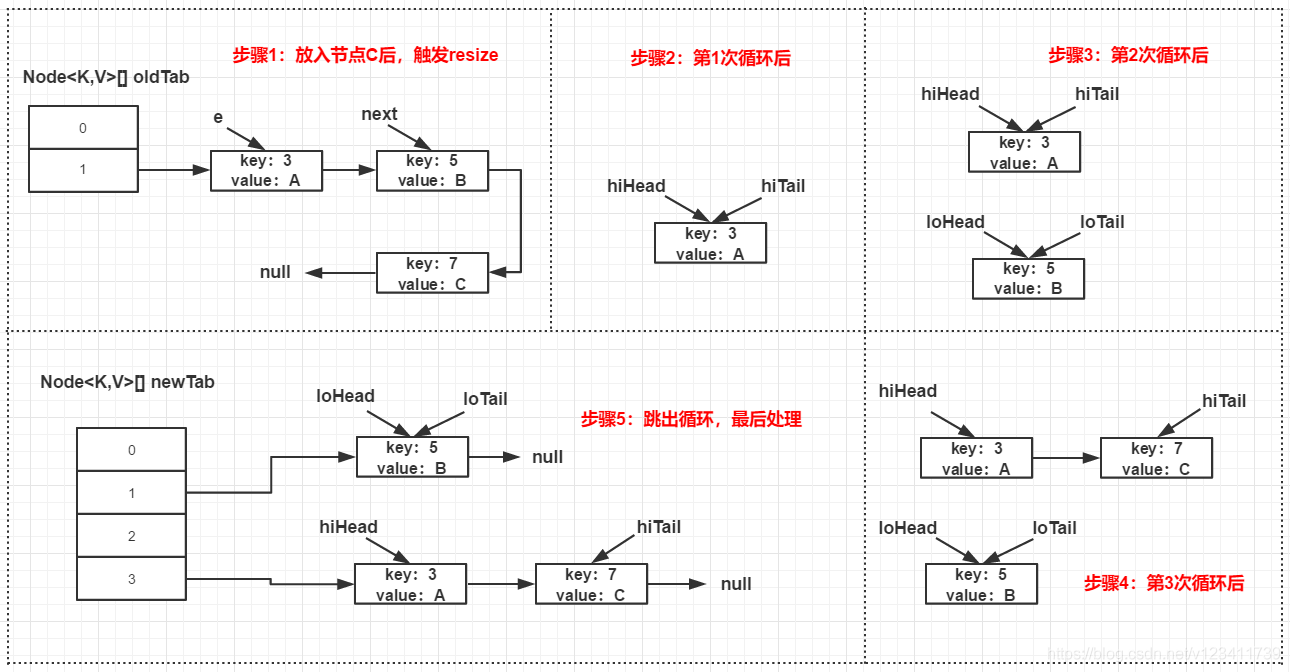
resize()方法会在两种情况下被调用:1)初始化,即第一次往HashMap中插入数据;2)Hashmap中键值对的数量大于阈值时进行扩容。- 每次扩容的时候都是扩容2被(旧容量往左移1位)。
- 扩展后Node对象的位置要么在原位置,要么移动到原偏移+原数组长度的位置。即一个Node本来在tab[i]处,扩容后要么还是在tab[i]处,要么移动到了tab[i+oldTab.length]处。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
|
final Node<K,V>[] resize() {
Node<K,V>[] oldTab = table;
int oldCap = (oldTab == null) ? 0 : oldTab.length;
int oldThr = threshold;
int newCap, newThr = 0;
if (oldCap > 0) {
if (oldCap >= MAXIMUM_CAPACITY) {
threshold = Integer.MAX_VALUE;
return oldTab;
}
else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
oldCap >= DEFAULT_INITIAL_CAPACITY)
newThr = oldThr << 1;
} else if (oldThr > 0)
newCap = oldThr;
else {
newCap = DEFAULT_INITIAL_CAPACITY;
newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
}
if (newThr == 0) {
float ft = (float)newCap * loadFactor;
newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ?
(int)ft : Integer.MAX_VALUE);
}
threshold = newThr;
@SuppressWarnings({"rawtypes","unchecked"})
Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
table = newTab;
if (oldTab != null) {
for (int j = 0; j < oldCap; ++j) {
Node<K,V> e;
if ((e = oldTab[j]) != null) {
oldTab[j] = null;
if (e.next == null)
newTab[e.hash & (newCap - 1)] = e;
else if (e instanceof TreeNode)
((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
else {
Node<K,V> loHead = null, loTail = null;
Node<K,V> hiHead = null, hiTail = null;
Node<K,V> next;
do {
next = e.next;
if ((e.hash & oldCap) == 0) {
if (loTail == null)
loHead = e;
else
loTail.next = e;
loTail = e;
}
else {
if (hiTail == null)
hiHead = e;
else
hiTail.next = e;
hiTail = e;
}
} while ((e = next) != null);
if (loTail != null) {
loTail.next = null;
newTab[j] = loHead;
}
if (hiTail != null) {
hiTail.next = null;
newTab[j + oldCap] = hiHead;
}
}
}
}
}
return newTab;
}
|
过程参考如下图:
get方法
get方法比较简单,大概流程就是:
- 根据key的hash值,得到应该查找的的数组索引i,判断tab[i]处的值是否是null,如果为null直接返回value为null。
- 如果不为null,判断数组上的这个节点的key和要查找的key是否相同(通过hash、queals、==等判断条件),如果相同,返回该节点的value。
- 如果步骤2中的key相等判断为false,则再检查当前节点是红黑树还是链表,分别用对应的方法遍历,最终看是否找到红黑树或链表里的节点key和查找的key是否相等,找到了就返回对应节点的value,没有找到则最后返回null。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
|
public V get(Object key) {
Node<K,V> e;
return (e = getNode(hash(key), key)) == null ? null : e.value;
}
final Node<K,V> getNode(int hash, Object key) {
Node<K,V>[] tab; Node<K,V> first, e; int n; K k;
if ((tab = table) != null && (n = tab.length) > 0 &&
(first = tab[(n - 1) & hash]) != null) {
if (first.hash == hash &&
((k = first.key) == key || (key != null && key.equals(k))))
return first;
if ((e = first.next) != null) {
if (first instanceof TreeNode)
return ((TreeNode<K,V>)first).getTreeNode(hash, key);
do {
if (e.hash == hash &&
((k = e.key) == key || (key != null && key.equals(k))))
return e;
} while ((e = e.next) != null);
}
}
return null;
}
|
remove方法
remove(Object key)方法其实就是根据key找到对应的节点并移除,不会改变哈希数组的长度。具体源码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
| public V remove(Object key) {
Node<K,V> e;
return (e = removeNode(hash(key), key, null, false, true)) == null ? null : e.value;
}
final Node<K,V> removeNode(int hash, Object key, Object value,
boolean matchValue, boolean movable) {
Node<K,V>[] tab; Node<K,V> p; int n, index;
if ((tab = table) != null && (n = tab.length) > 0 &&
(p = tab[index = (n - 1) & hash]) != null) {
Node<K,V> node = null, e; K k; V v;
if (p.hash == hash &&
((k = p.key) == key || (key != null && key.equals(k))))
node = p;
else if ((e = p.next) != null) {
if (p instanceof TreeNode)
node = ((TreeNode<K,V>)p).getTreeNode(hash, key);
else {
do {
if (e.hash == hash &&
((k = e.key) == key ||
(key != null && key.equals(k)))) {
node = e;
break;
}
p = e;
} while ((e = e.next) != null);
}
}
if (node != null && (!matchValue || (v = node.value) == value ||
(value != null && value.equals(v)))) {
if (node instanceof TreeNode)
((TreeNode<K,V>)node).removeTreeNode(this, tab, movable);
else if (node == p)
tab[index] = node.next;
else
p.next = node.next;
++modCount;
--size;
afterNodeRemoval(node);
return node;
}
}
return null;
}
|